资源
全文
Abstract
基于深度学习的场景文本检测算法在充分利用已标注的训练数据的基础上,能够获得较好的检测性能。然而,手动贴标签费时费力。在极端情况下,相应的注释数据不可用。利用合成数据是一种非常有前途的解决方案,但合成数据与真实的数据之间的域分布不匹配除外。针对场景文本检测中存在的严重域分布不匹配问题,提出了一种从合成域到真实的域的自适应场景文本检测方法。本文提出了一种基于文本自训练(TST)和对抗性文本实例对齐(ATA)的自适应场景文本检测方法。ATA 通过以对抗的方式训练域分类器来帮助网络学习域不变特征。TST 减少了来自不准确伪标签的假阳性(FP)和假阴性(FN)的不利影响。当从合成场景适应到真实的场景时,两个分量对提高场景文本检测器的性能有积极的作用。我们通过从 SynthText、VISD 转移到 ICDAR2015、ICDAR2013 对所提出的方法进行了评估。实验结果验证了所提方法的有效性,提高了 10% 以上,对领域自适应场景文本检测具有重要的探索意义。
1 Introduction
场景文本检测因其在计算机视觉中的众多应用而受到越来越多的关注。此外,在过去的几十年里,场景文本检测取得了巨大的成功。然而,这些检测方法需要手动标记大量的训练数据,这非常昂贵且耗时。虽然已经存在几个公共基准,但它们只涵盖了非常有限的场景。在现实世界中,特定的应用程序任务通常需要收集和注释新的训练数据集,而收集足够的标记数据是困难的,甚至是不可能的。因此,昂贵的标签成本已成为基于深度学习方法的文本检测应用的主要问题。
随着计算机图形学的飞速发展,一种可供选择的方法是利用大量可从虚拟世界中获得的合成数据,并且可以自由地和自动地生成地面实况。
- SynthText 首先提供了一个虚拟场景文本数据集,并自动生成带有单词级和字符级注释的合成图像。
- VISD 为文本合成配备了选择性语义分割,以产生更真实的样本。
- UnrealText 通过 3D 图形引擎提供逼真的虚拟场景文本图像,该 3D 图形引擎通过将场景和文本作为一个整体呈现来提供逼真的外观。
尽管合成数据提供了在训练场景文本检测器中替代真实的图像的可能性,其具有低标注成本和高标注精度,但是许多先前的工作也表明,由于被称为“域移位 Domain Shift”的现象,仅使用合成数据的训练降低了对真实的数据的性能。如图 1 所示,与常见对象不同,文本在现实场景中具有更多的形状、颜色、字体、大小和方向的多样性,这导致合成数据与真实的数据之间存在较大的域差距。因此,当仅从合成数据向真实的数据应用模型学习时,模型的性能显著降低。
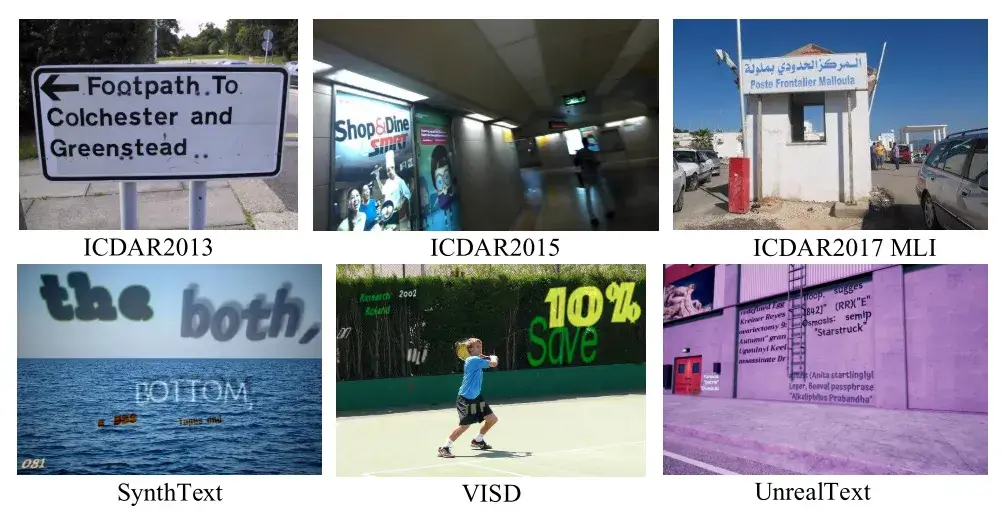
为了解决域偏移问题,提出了一种基于合成到真实的域的场景文本检测方法,该方法利用合成数据和未标记的真实的数据,有效地提高了模型在真实的数据上的性能。受 [1909.00597] Self-Training and Adversarial Background Regularization for Unsupervised Domain Adaptive One-Stage Object Detection (arxiv.org) 和 [1409.7495] Unsupervised Domain Adaptation by Backpropagation (arxiv.org) 的启发,本文提出了一种文本自训练(TST)方法和一种对抗性文本实例对齐(ATA)来减少域移位。
自训练在领域自适应常见对象检测和语义分割方面取得了出色的结果。然而,场景文本检测任务更多样化的情况下,复杂的背景还没有在这个方向上探索。为了更好地将自训练应用于场景文本检测,TST 用于抑制伪标签中出现的假阳性和假阴性的不利影响。此外,我们首先利用对抗学习帮助模型学习场景文本的区分特征。对抗性学习已被证明在域自适应图像分类和常见对象检测等任务中是有效的。由于大多数场景文本检测器都是单阶段检测器,因为它们没有区域建议过程,因此我们提出 ATA 以对抗训练方式对齐文本实例的判别特征。本文的主要贡献如下:
- 我们引入文本自训练(TST),通过最小化不准确伪标签的不利影响来提高域自适应场景文本检测的性能。
- 我们提出了对抗性文本实例对齐(ATA)来帮助模型学习域不变特征,从而增强模型的泛化能力。
- 我们首先介绍了一种用于场景文本检测的合成到真实的域自适应方法,该方法将知识从合成数据(源域)转移到真实的数据(目标域)。
通过针对场景文本检测传输任务(例如,SynthText → ICDAR 2015)。实验结果表明,该方法能够有效解决场景文本检测中的域偏移问题,对领域自适应场景文本检测具有重要的探索意义。
2 Related Work
2.1 Scene Text Detection
简介场景文本检测。
2.2 Domain Adaptation
领域自适应减少了训练数据和测试数据之间的领域差距。最近的方法使用更有效的方法来减少域间隙,例如将域分类器与梯度反转结合。
2.3 Self-Training
先前的工作使用自我训练来弥补分类信息的缺乏。然而,由于前期工作的不足,文本检测在自训练方法上还需要进一步的探索。
3 Proposed Method
在这一节中,分析了由畴移引起的问题。此外,我们介绍了 TST 和 ATA 的原理,以及如何使用它们进行域适配。为了评估我们的方法,采用 EAST 作为基线。
3.1 Problem and Analysis
虽然合成场景文本数据可以自动生成多样化的外观和准确的 GT,但仅用合成数据训练的模型不能直接应用于真实的场景,因为合成数据集和真实的数据集之间存在显著的域偏移。从概率的角度看问题会更清楚。我们将合成数据域称为源域,将真实的数据域称为目标域。场景文本检测问题可以看作是学习后验 (已知图像特征求预测边界框),其中 是指图像特征, 是文本实例的预测边界框。使用贝叶斯公式,后验 可以分解为:
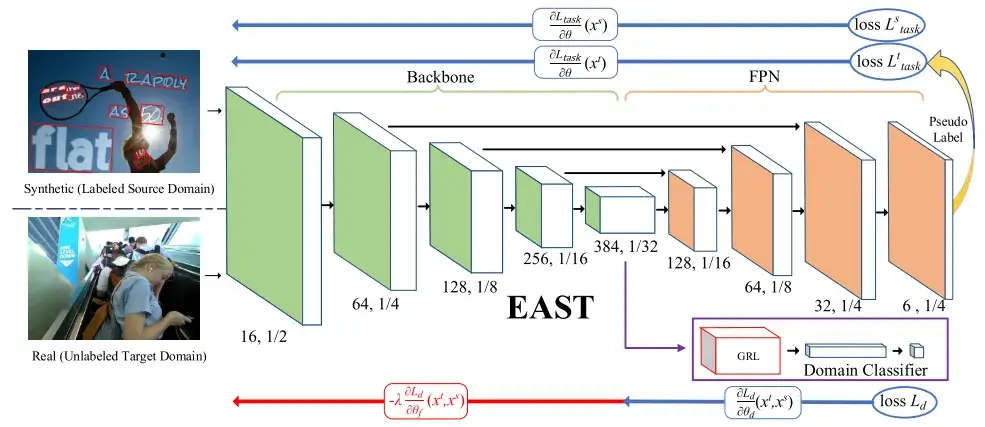
我们在此任务中进行协变量移位假设,即先验概率 对于两个域是相同的(预测边界框的划定相同,正确划定出文本的范围)。是指 的条件概率,这意味着在给定预测结果为真的情况下学习到真特征的可能性。我们还考虑了 对于两个域而言是相同的。因此,后验概率的差异由先验概率 引起(提取出的特征不同)。换句话说,为了检测文本实例,检测结果中的差异是由域改变特征引起的。为了提高模型的泛化能力,模型需要学习更多的域不变特征,无论输入图像属于哪个域都保持相同的 (迫使模型在读取合成数据和真实数据时,都提取出同样的特征)。在 EAST 模型中,图像特征 是指从 backbone 输出的特征。因此,特征图应该在源域和目标域之间对准(即,)。为了实现这一目标,我们建议 ATA 协调这些特性,下一小节将介绍更多详细信息。
3.2 Adversarial Text Instance Alignment
受 [1409.7495] Unsupervised Domain Adaptation by Backpropagation (arxiv.org) 的启发,采用 ATA 来帮助网络学习域不变特征。在 EAST 模型中,图像特征 是指主干的特征图输出(即,384,图 2 中的 1/32 特征)。为了在源域和目标域之间对齐特征 ,使用域分类器来混淆特征域。具体地,针对每个输入图像训练域分类器,并预测图像所属的域标签(代码中 y_pred_prob_f)。我们假设模型的输入样本为 ,其中 是某个输入空间。 表示第 个训练图像的域标签(代码中 y_true),对于源域 ,对于目标域 。 是域分类器的输出,我们使用交叉熵作为损失函数:
def bce_loss(y_true, y_pred_logits):
    # y_true:真实标签(0 或 1)。
    # y_pred_logits:模型的原始预测值(logits),即未经过激活函数的输出。
    # y_pred_prob = F.sigmoid(y_pred_logits)
    # y_true_f = y_true.view(-1)
    # y_true_f = y_true
    y_pred_logits = y_pred_logits.view(-1)
    y_pred_prob_f = y_pred_logits.clamp(min=1e-7, max=1 - 1e-7)  # 调整预测值范围:将预测值限制在 [1e-7, 1 - 1e-7] 之间,以防止对数计算时出现数值不稳定。
    return -(y_true * y_pred_prob_f.log() + (1. - y_true) * (1 - y_pred_prob_f).log()).mean()  # 计算交叉熵损失,并返回平均损失。
为了学习域不变特征,我们以对抗的方式优化参数。通过最小化上述域分类损失来优化域分类器的参数,并且通过最大化该损失来优化基础网络的参数。更详细地说,梯度反转层(GRL)被添加在 EAST 的主干和域分类器之间,当通过 GRL 层时,梯度的符号被反转(梯度反转层主要同在特征提取器与域分类器之间,那么在反向传播过程中,域分类器的域分类损失的梯度反向传播到特征提取器的参数之前会自动取反,进而实现了类似与 GAN 的对抗损失。)。如图 2 所示,特征金字塔网络(FPN)和骨干网在训练阶段都最小化了 EAST 的原始损失 。 具体表示 EAST 中的评分图损失和几何形状损失。 任务是指在目标域中使用伪标签进行训练, 任务表示在源域中进行训练。因此,不同参数空间的训练目标不同:
- 骨干网络的目标:最小化检测的损失、最大化域分类器的损失(既要骗过 Domain Classifier,又要提取出有价值的特征。)
- 域分类器的目标:最小化域分类器的损失
- FPN 的目标:最小化检测的损失(依旧做标签预测。)
其中 、、 分别是骨干、域分类器和 FPN 的参数空间。总体训练目标如下:
class Loss_target(nn.Module):
    def __init__(self, weight_angle=10):
        # 角度损失的权重系数。默认为 10,用于控制角度损失在总损失中的影响程度。
        super(Loss_target, self).__init__()
        self.weight_angle = weight_angle
        self.bce = bce_loss
        # 指定使用的二分类交叉熵损失函数 (bce_loss),它在 forward 方法中用来计算领域损失。

    def forward(self, gt_score, pred_score, gt_geo, pred_geo, ignored_map,pre_domain):
        if torch.sum(gt_score) < 1:
            return torch.sum(pred_score + pred_geo) * 0
        # 如果 gt_score 的总和小于 1(表示没有有效的目标),则返回 0 作为损失,避免计算损失时出现错误或不必要的计算。

        classify_loss = get_dice_loss(gt_score, pred_score*(1-ignored_map))
        # 使用 get_dice_loss 计算分类损失。pred_score * (1 - ignored_map) 是预测分数与忽略区域掩码结合后的结果,确保在计算损失时忽略掉指定的区域。

        gt_doamin = torch.Tensor([[[1.]]]).to(torch.device("cuda"))
        doamin_loss = self.bce(gt_doamin, pre_domain)
        # 生成一个目标领域分数 gt_doamin,设为 1,并将其转移到 GPU 设备上。使用 bce_loss 计算领域损失,这里领域损失衡量模型预测的领域分数与目标领域分数之间的差异。

        iou_loss_map, angle_loss_map = get_geo_loss(gt_geo, pred_geo)

        angle_loss = torch.sum(angle_loss_map * gt_score) / torch.sum(gt_score)
        iou_loss = torch.sum(iou_loss_map * gt_score) / torch.sum(gt_score)
        geo_loss = self.weight_angle * angle_loss + iou_loss
        # 使用 get_geo_loss 计算几何损失,包括交并比(IoU)损失和角度损失。
        # 计算角度损失和 IoU 损失,并根据 weight_angle 进行加权,得到总的几何损失。
        # print('classify loss is {:.8f}, angle loss is {:.8f}, iou loss is {:.8f}'.format(classify_loss, angle_loss, iou_loss))
        return geo_loss, classify_loss, doamin_loss  # 返回三个损失值:几何损失、分类损失和领域损失。
其中 是权衡参数,我们在所有实验中将其设置为 0.2。通过优化损失,网络可以学习更多的文本域不变特征,更好地从合成数据转换到真实的数据。
cfg = [64, 64, 'M', 128, 128, 'M', 256, 256, 256, 'M', 512, 512, 512, 'M', 512, 512, 512, 'M']  # 配置列表,指定网络层的类型和数量。

def make_layers(cfg, batch_norm=False):
    layers = []  # 列表用于存储创建的层。
    in_channels = 3  # 初始化为 3,对应输入图像的通道数。
    for v in cfg:
        if v == 'M':  # 如果值为 'M',添加一个 2x2 的最大池化层。
            layers += [nn.MaxPool2d(kernel_size=2, stride=2)]
        else:  # 否则,创建一个卷积层(nn.Conv2d),后跟可选的批归一化层和 ReLU 激活函数。
            conv2d = nn.Conv2d(in_channels, v, kernel_size=3, padding=1)
            if batch_norm:
                layers += [conv2d, nn.BatchNorm2d(v), nn.ReLU(inplace=True)]
            else:
                layers += [conv2d, nn.ReLU(inplace=True)]
            in_channels = v  # 更新 in_channels 为当前卷积层的输出通道数 v。
    return nn.Sequential(*layers)  # 使用 nn.Sequential 将所有层打包成一个顺序容器,返回构造好的网络层。


class VGG(nn.Module):
    def __init__(self, features):
        super(VGG, self).__init__()
        self.features = features  # self.features:存储卷积层。
        self.avgpool = nn.AdaptiveAvgPool2d((7, 7))  # 自适应平均池化层,将特征图大小调整为 7x7。
        self.classifier = nn.Sequential(
            nn.Linear(512 * 7 * 7, 4096),
            nn.ReLU(True),
            nn.Dropout(),
            nn.Linear(4096, 4096),
            nn.ReLU(True),
            nn.Dropout(),
            nn.Linear(4096, 1000),
        )  # 全连接层的序列,包括两个 ReLU 激活层和 Dropout 层,用于分类。

        for m in self.modules():  # 初始化权重
            if isinstance(m, nn.Conv2d):
                nn.init.kaiming_normal_(m.weight, mode='fan_out', nonlinearity='relu')
                if m.bias is not None:
                    nn.init.constant_(m.bias, 0)
            elif isinstance(m, nn.BatchNorm2d):
                nn.init.constant_(m.weight, 1)
                nn.init.constant_(m.bias, 0)
            elif isinstance(m, nn.Linear):
                nn.init.normal_(m.weight, 0, 0.01)
                nn.init.constant_(m.bias, 0)

    def forward(self, x):
        x = self.features(x)  # 通过 self.features 处理输入 x。
        x = self.avgpool(x)  # 应用自适应平均池化,将特征图调整为 7x7。
        x = x.view(x.size(0), -1)  # 将池化后的特征图展平,以适应全连接层输入。
        x = self.classifier(x)  # 通过 self.classifier 进行最终的分类预测。
        return x


class extractor(nn.Module):  # 特征提取层。
    def __init__(self, pretrained):
        super(extractor, self).__init__()
        vgg16_bn = VGG(make_layers(cfg, batch_norm=True))  # 使用 VGG 类创建带有批量归一化的 VGG16 网络。
        if pretrained:
            # state_dict = load_state_dict_from_url('https://download.pytorch.org/models/vgg16-397923af.pth')
            # vgg16_bn.load_state_dict(state_dict)
            if pretrained:  # 如果 pretrained 为 True,则加载本地路径的预训练权重。
                vgg16_bn.load_state_dict(torch.load(
                    '/data/data_weijiawu/Sence_Text_detection/Paper-ACCV/baseline/EAST_1/vgg16_bn-6c64b313.pth'))
        self.features = vgg16_bn.features  # self.features 被设置为 VGG16 网络的卷积层部分。(使用 VGG16 进行特征提取)

    def forward(self, x):
        out = []
        for m in self.features:  # 遍历 self.features 中的每一层,对输入 x 进行逐层处理。
            x = m(x)
            if isinstance(m, nn.MaxPool2d):  # 将每个最大池化层的输出保存到 out 列表中。
                out.append(x)
        return out[1:]  # 返回 out[1:],即从第二个池化层开始的特征图。这通常是为了匹配特定的特征提取需求。
3.3 Text Self-Training
以前的工作已经证明了自我训练对领域适应的有效性。然而,自我训练的两个主要问题仍然需要进一步探讨:假阳性(FP)(实际没有,预测有)和假阴性(FN)(实际有,预测没有)发生在伪标签。不正确的伪标签会对我们的网络造成非常严重的负面影响。为了克服这些问题,TST 被设计成最小化 FP 和 FN 的不利影响。
3.3.1 Reducing False Negatives.
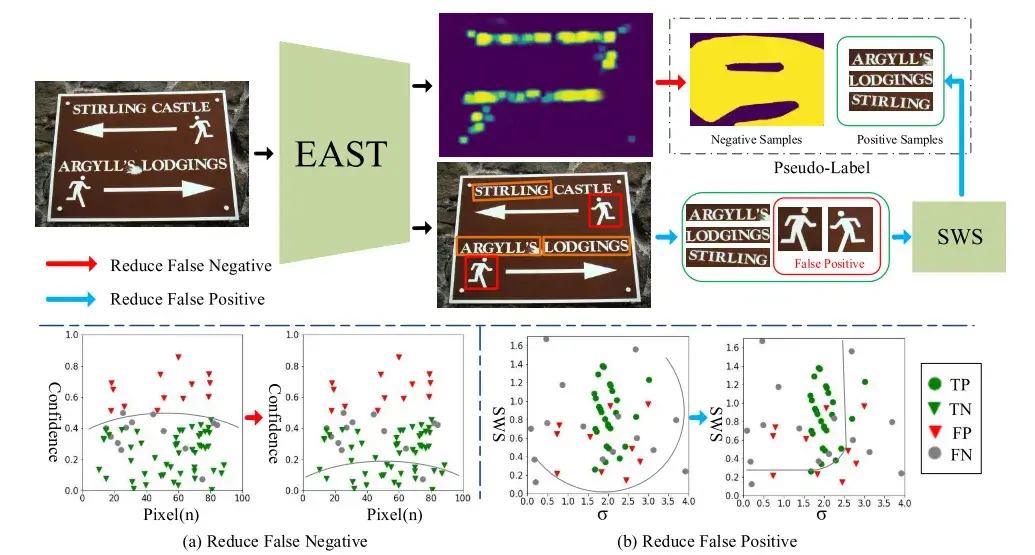
受 [1909.00597] Self-Training and Adversarial Background Regularization for Unsupervised Domain Adaptive One-Stage Object Detection (arxiv.org) 的启发,利用弱监督方式来最小化假阴性的影响。如 EAST 中所定义的,原始分数图损失是
其中 是分数图的预测, 是基本事实。
虽然网络是通过反向传播学习背景损失(即负面例子)来优化的,但在伪标签中出现的 误导了网络。我们假设 主要是通过硬负挖掘来选择的,例如模糊的文本和与背景相似的不寻常字体。为了减少 的不利影响,我们忽略了一些有可能成为置信度得分的前景的背景例子。
EAST 的负面例子是像素图,一个像素更有可能被视为负面像素,而相应的置信度得分更高。
因此,我们选择置信度得分最低的负样本像素(例如,)的一部分作为最终的负示例,在图中表示为 (红线)。相应的数学表达式为 ,其中 在所有实验中都设置为 。对于那些具有高置信度分数的像素,网络不会优化该部分损失。最后,修改后的损失函数定义为:
3.3.2 Reducing False Positives.
与假阴性相对应的是,假阳性也会对网络造成严重干扰。自然场景中的一些图案和设计极易被识别为文本,从而导致伪标签不准确。取支持区域可靠分数(SRRS),我们提出了一种更合理的笔划宽度分数(SWS),该分数利用笔划宽度变换(SWT)来评估文本实例的预测框。
EAST 是一种基于分割的方法,不需要 FPN,对于面积较小的文本实例,)比面积大的支承箱数量多,这就导致了支承箱数量(即,)的函数。另一方面,SWT 对于消除非文本区域更合理,并且类似的先前工作已经显示了其有效性。SWT 是一个局部图像运算符,它计算每个像素的最可能笔划宽度。SWT 的 输出是一个 矩阵,其中每个元素包含与该像素相关联的笔划的宽度。具体地说,笔划边界上的每个象素在梯度方向上与笔划的相对侧相连,并且连接线的宽度是该象素的笔划宽度。SWS 利用相应笔画宽度的信息对预测的方框进行评估,并消除部分非文本区域,如图 3(蓝线)所示。对于典型的文本区域,笔画宽度的变化很小,因为文本倾向于保持固定的笔画宽度。我们将第 v 个预测框中的笔划宽度的集合表示为 ,并且将 像素的笔划宽度表示为 。标准差如下:
其中 是 个预测框中的平均笔画宽度。因此,每个预测框都有一个关于笔画宽度的标准差(),我们选择具有上限阈值()的可靠框。此外,我们还通过 SWS 进一步过滤框:
是第 个预测框的最常见的笔画宽度值。通过用较低的阈值 对分数进行阈值化,进一步选择框。图 3(b)显示部分 FP 被 SWS 和 滤除。
4 Experiments
通过将场景文本检测器从合成数据集转移到真实的数据集来评估所提出的方法。我们采用几个纯合成数据和真实的场景数据(即,SynthText 和 ICDAR2015),它们具有共同的注释风格(即,字级)。
4.1 Dataset and Experimental Settings
4.1.1 Pure Synthetic Datasets.
-
SynthText 是一个包含约 80 万合成图像的大规模数据集。这些图像是通过将自然图像与随机字体,大小,颜色和方向渲染的文本混合而创建的,因此这些图像非常逼真。
-
VISD 包含与 10k 背景图像合成的 10k 图像。因此,该数据集没有重复的背景图像。丰富的背景图像使该数据集更加多样化。
4.1.2 Real Datasets.
-
ICDAR 2015 是一个面向英文文本的多方向文本检测数据集,仅包含 1,000 张训练图像和 500 张测试图像。此数据集中的场景文本图像由 Google 眼镜拍摄,没有考虑定位,图像质量和视点。该数据集具有小的,模糊的和多方向的文本实例。
-
ICDAR 2013 在 ICDAR 2013 Robust 阅读竞赛期间发布,用于聚焦场景文本检测,包括高分辨率图像,229 用于训练,233 用于测试,包含英文文本。
4.1.3 Implementation Details.
在所有实验中,我们使用 EAST 作为基础网络。在原始论文之后,输入被调整为 512×512,并且我们应用了原始论文中使用的所有增强。该网络使用由 12 幅图像组成的批量输入进行训练,其中 6 幅图像来自源域,另外 6 幅图像来自目标域。Adam 优化器被采用作为我们的学习率方案。所有实验都使用相同的训练策略:
- 使用 ATA 对网络进行 80k 次迭代的预训练,以学习域不变特征,
- 使用预训练的模型来生成相应的伪标签(即,伪边界框标签和负样本图),然后用生成的伪标签微调预训练模型。在生成伪标签的过程中,我们将笔划宽度消除参数设置为 3.0 和 0.30。
所有实验都在常规工作站(CPU:Intel(R)Core(TM)i7- 7800 X CPU@3.50 GHz; GPU:GTX 2080 Ti)上进行。
4.2 Performance Comparison and Analysis
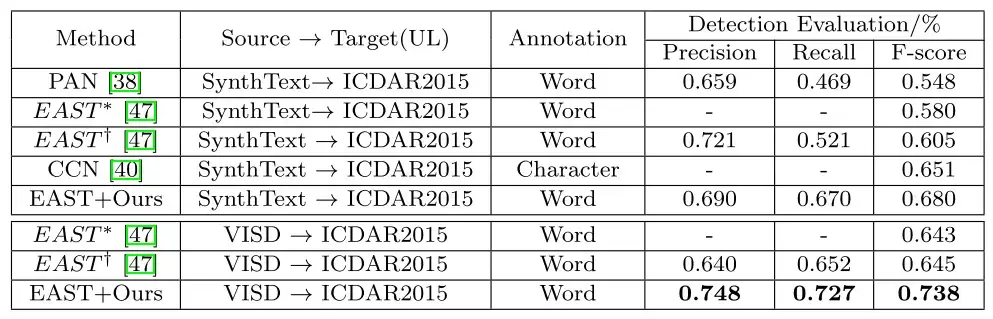
4.2.1 Synthetic→ ICDAR2015 Transfer.
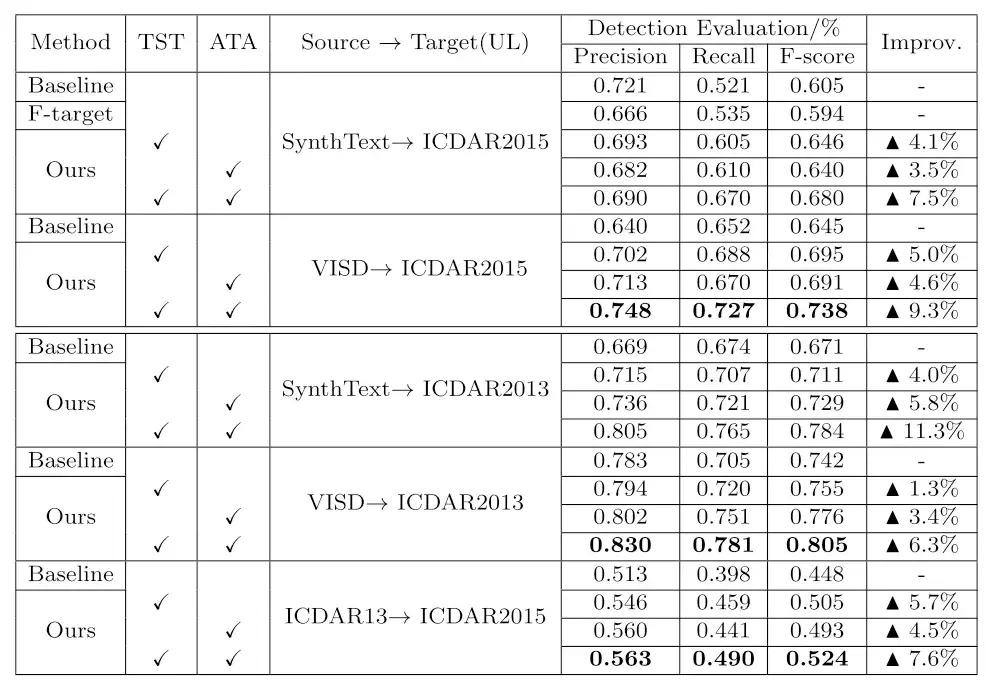
表 1 总结了合成→ ICDAR 2015 转移任务的性能比较。EAST 模型作为仅使用源代码的基线训练具有不令人满意的 F 分数(使用 SynthText 为 60.5%,使用 VISD 为 64.5%),这可以被视为没有自适应的下限。通过结合所提出的方法,F-评分分别达到 68.0% 和 73.8%,比基线分别提高了 7.5% 和 9.3%。基于字符注释的 GCN 比基于单词注释的性能有所提高。然而,GCN 的性能仍然低于我们的方法,它利用了自我训练和对抗学习。实验结果表明,该方法能够有效地消除源数据和目标数据的领域差异。
4.2.2 Synthetic→ ICDAR2013 Transfer.
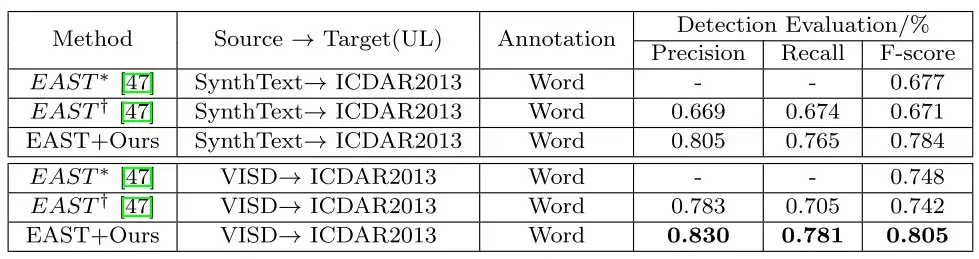
为了进一步验证该方法的有效性,以 ICDAR 2013 为目标域,进行了合成到真实的场景文本检测迁移的实验。实验结果报告在表 2 中。具体来说,对于 SynthText→ ICDAR 2013 转移任务,与仅使用源代码的基线 EAST 训练相比,我们实现了 11.3% 的性能提升。与合成→ICDAR2015 转移实验类似,VISD 也被用作比较实验中的源域。在使用 ATA 和 TST 后,该方法比基线 EAST 的性能提高了 6.3%,这表明该方法在减少域偏移方面的有效性。请注意,为了公平比较,除了添加 ATA 和 TST 之外,所提出的方法的基础网络和实验设置与基线 EAST 相同。
4.2.3 ICDAR2013→ ICDAR2015 Transfer.
表 3 显示了 ICDAR 2013 → ICDAR 2015 转移任务的性能。ICDAR 2013 的注释是矩形框,而 ICDAR 2015 的注释是旋转框,这限制了传输性能。然而,与仅使用源代码的基线 EAST 训练相比,我们实现了 7.6% 的性能提升。
4.3 Ablation Study
4.3.1 Component Analysis.
为了验证所提出方法的有效性,我们在四个数据集上进行了 Syn2Real 转移任务的消融实验:SynthText、VISD、ICDAR2015 和 ICDAR2013。表 3 显示了实验结果。对于 SynthText→ICDAR2015 转移任务,使用 TST 和 ATA 后,F-得分分别提高了 4.1% 和 3.5%。此外,我们的方法比基线产生了高达 8% 的召回率,这表明了这种方法在提高模型鲁棒性方面的有效性。通过结合这两个组成部分,所提出方法的 F-得分达到了 68.0%,比基线绝对提高了 7.5%。VISD→ICDAR2015 转移任务表现更好,因为 VISD 具有更真实的合成效果。特别是,使用我们的方法的 F-得分达到了 73.8%,比相应的基线绝对提高了 9.3%。对于 SynthText/VISD→ICDAR2015 的传输,性能的提高也很显著。我们使用 SynthText 实现了 11.3% 的性能改进,使用 VISD 实现了 6.3% 的性能改善。
4.3.2 Parameter Sensitivity on TST.
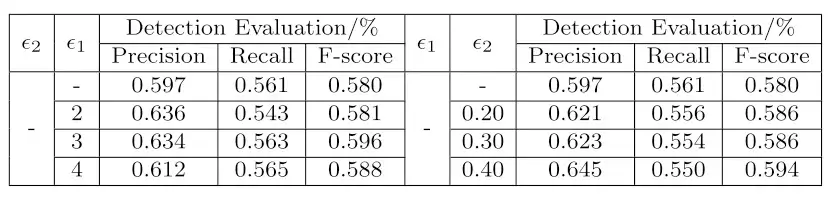
为了探索阈值参数(即,在 SWS 上,我们进行了几组比较实验,结果如表 4 所示。由于我们认为在理想情况下文本区域中的笔画宽度的标准差接近于零,因此使用阈值参数 来过滤预测框。结果表明,当神经网络的参数为 1 时,网络的性能最好,且网络的性能对参数的变化不敏感。与 相似,采用 0.2、0.3、0.4 三个不同的值对 的参数敏感性进行了验证,结果表明 的值(0.3)是合理的。
4.3.3 Qualitative Analysis.
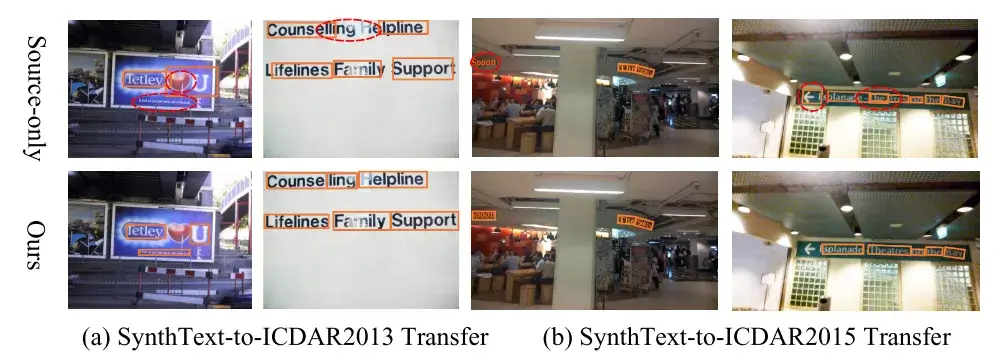
图 4 示出了用于合成到真实的转换任务的文本检测结果的四个示例。实验结果表明,该方法提高了模型在不同复杂背景和不同文本下的鲁棒性。TST 最小化了 FP 和 FN 的一部分,如第一列示例所示,ATA 帮助模型学习更多有区别的特征。
5 Conclusions
本文首先介绍了一种用于场景文本检测的合成域到真实的域自适应方法,该方法将知识从合成数据(源域)转移到真实的数据(目标域)。提出的文本自训练(TST)有效地减少了伪标签的假阴性和假阳性的不利影响,而对抗性文本实例对齐(ATA)有助于网络以对抗的方式学习更多的域不变特征。我们评估了所提出的方法与 EAST 在几个常见的合成和真实的数据集。实验结果表明,该方法对于合成到真实的迁移文本检测任务有很大的改进。